WebRTC × ZeroMQ × GPU Worker — 실시간 영상 AI를 클라우드로 옮긴 결정들
Electron 데스크톱 앱이었던 FaceSwap 서비스를 브라우저 기반 클라우드로 전환하기 위해 설계한 3-Tier 분산 아키텍처의 의사결정 기록
WebRTC × ZeroMQ × GPU Worker — 실시간 영상 AI를 클라우드로 옮긴 결정들
Electron 데스크톱 앱이었던 FaceSwap 서비스를 브라우저 기반 클라우드 서비스로 전환하기 위해, 시스템을 세 계층으로 나눴다. 그 과정에서 우리가 마주친 트레이드오프와, 그 선택을 단단하게 만든 운영 경험을 정리한다.
1. 시작 — "브라우저만 있으면 누구나 쓸 수 있게"
기존 FaceSwap 서비스는 Electron 기반 데스크톱 앱이었다. 사용자는 직접 설치 파일을 받고, 고사양 CPU·GPU·RAM이 있어야 했으며, 모델이 업데이트될 때마다 앱을 다시 받아야 했다. "브라우저만 있으면 누구나 쓸 수 있게" — 이 한 줄이 출발점이었다.
2. 본 글의 범위
본 글은 Veilio Cloud의 WebRTC Signaling 서버, ZeroMQ 기반 MQ 서버, GPU Worker, Docker Compose 인프라 구성 일체의 설계·구현 과정을 다룬다. FaceSwap 추론 모델 자체(인사이트페이스/ONNX 기반 face_swapper, face_enhancer 등)는 외부 모듈을 사용했으며, 본 글은 그 모델을 실시간 트래픽 위에서 안정적으로 서빙하기 위한 분산 시스템 레이어에 초점을 둔다.
3. 문제 — Electron 앱의 세 가지 한계
"브라우저로 옮긴다"는 한 줄의 목표는 곧 세 가지 문제로 분해됐다.
첫째, 사용자 진입장벽. Electron 앱은 사용자에게 고사양 CPU·GPU·RAM을 요구했다. 모델을 GPU에서 돌리려면 사용자 본인의 디바이스가 충분한 VRAM을 가져야 했고, 이는 시장 규모를 자기 디바이스에서 모델을 돌릴 수 있는 사용자로 좁혔다.
둘째, 배포 마찰. 모델이 개선되거나 코드가 업데이트되면 사용자가 직접 새 버전을 받아 설치해야 했다. 사용자 100%가 같은 버전을 쓰는 데까지 며칠~몇 주가 걸렸다.
셋째, 확장의 천장. 모든 연산이 사용자 디바이스에서 일어나면, 우리가 서버에서 할 수 있는 최적화의 여지가 없었다. 모델 양자화, 캐싱, A/B 테스트 — 모두 클라이언트가 우리 통제 아래에 있을 때만 가능한 일이었다.
해결의 방향은 명확했다 — AI 연산을 서버로, 입출력만 브라우저로 옮긴다. 그러나 단순히 "서버로 옮긴다"가 답이 아니었다. 실시간 영상은 100ms 단위의 지연이 사용자 경험을 직접 결정하는 도메인이다. 어떤 프로토콜로 영상을 옮길지, 어떻게 GPU에 분배할지 — 이 두 질문이 시스템의 척추가 되었다.
4. 접근 — 시스템을 세 계층으로
앞의 두 질문에 대한 답으로, 시스템을 세 계층으로 나눴다.
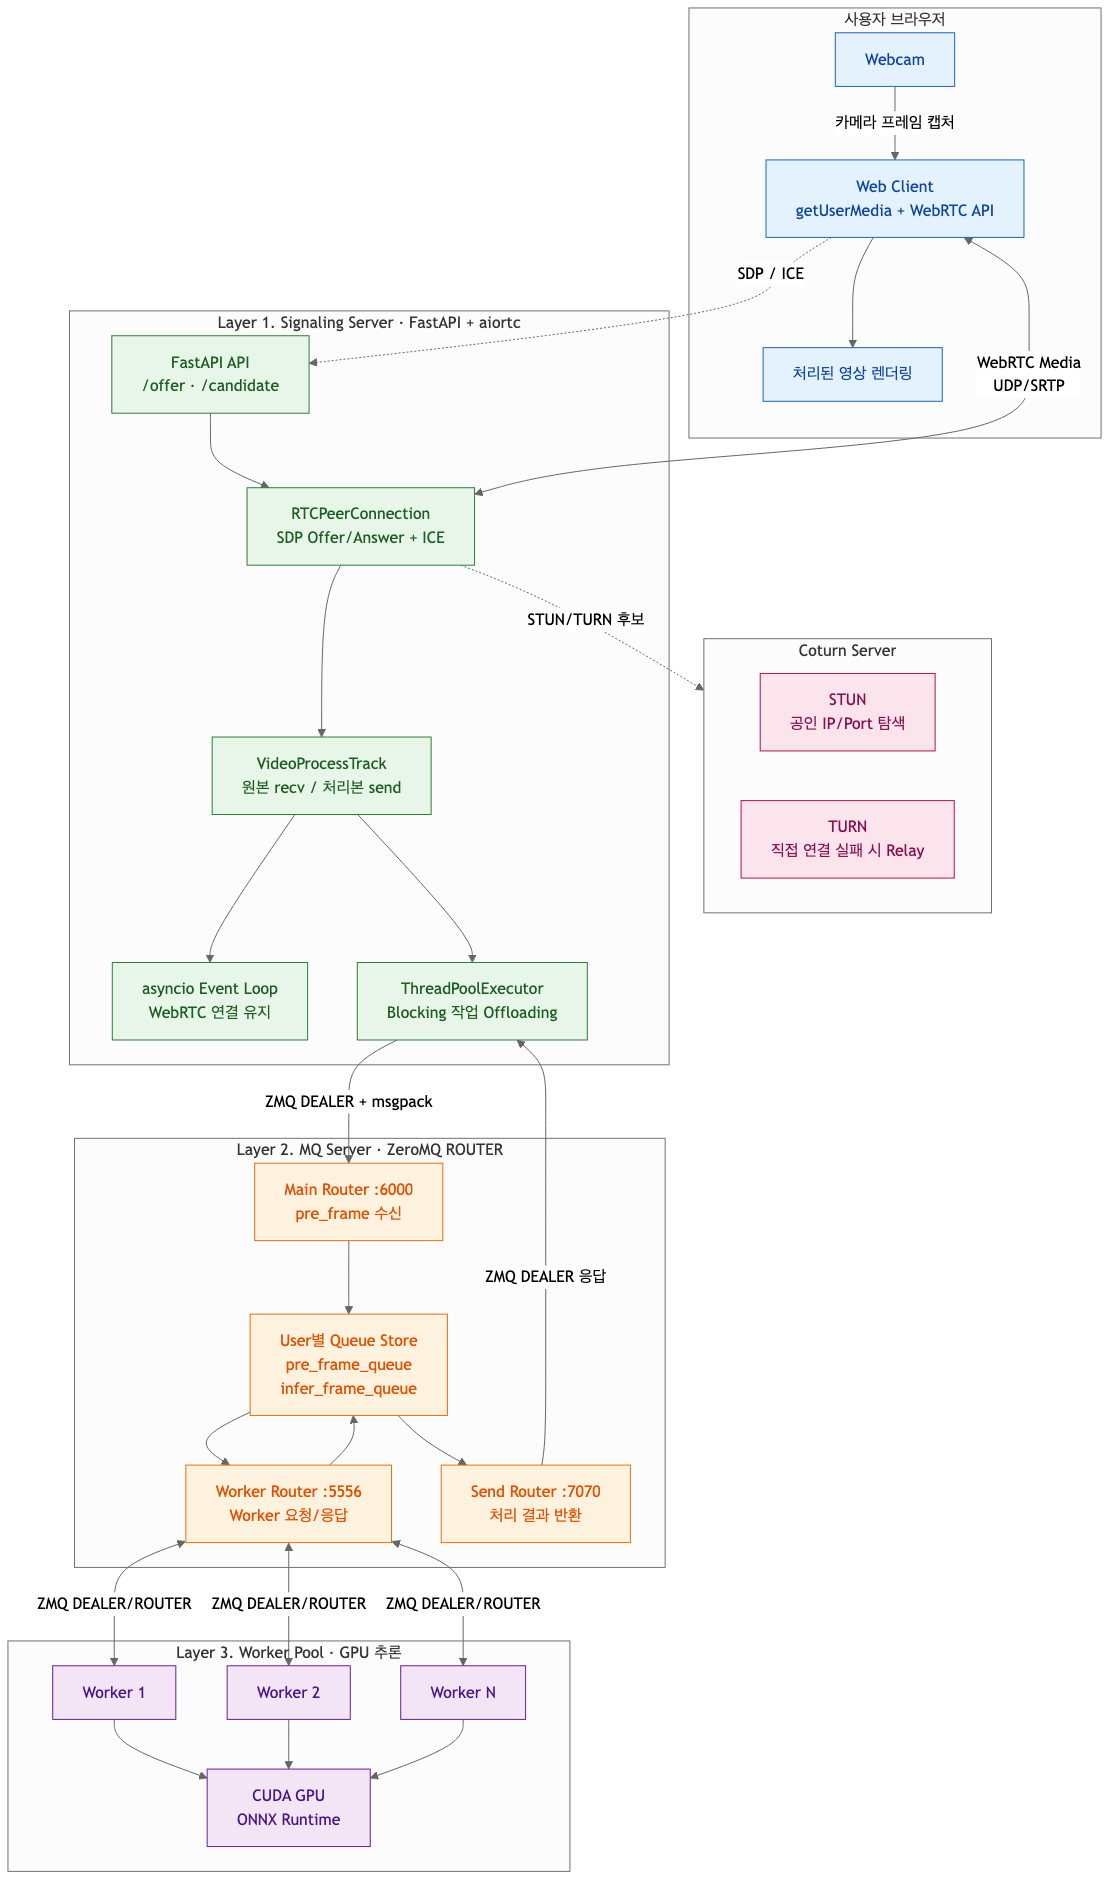
- Tier 1. Signaling Server — FastAPI + aiortc로 구성된 WebRTC 종단. 브라우저와의 미디어 채널을 유지하고, SDP/ICE 교환을 처리한다.
- Tier 2. MQ Server — ZeroMQ ROUTER 세 개로 구성된 메시지 라우터. 사용자별 큐와 Worker 풀 라우팅을 담당한다 (Main Router :6000, Worker Router :5556, Send Router :7070).
- Tier 3. Worker Pool — CUDA + ONNX Runtime 위에서 도는 GPU 추론 컨테이너. 수평 확장 가능한 풀로 운영된다.
세 계층 사이의 연결은 모두 ZeroMQ DEALER/ROUTER 패턴이고, 페이로드는 msgpack으로 직렬화된다. 글의 나머지는 — 왜 정확히 이렇게 나눴는지, 그리고 그 결정 하나하나가 어떤 트레이드오프 위에 서 있는지를 풀어가는 일이다.
5. Why WebRTC — TCP의 보장이 우리 도메인에서는 부담이었다
가장 먼저 떠올린 건 WebSocket이었다. 양방향이고, 브라우저 네이티브이며, 디버깅이 쉽다. 처음에는 이게 답으로 보였다. 그래서 WebSocket + JSON + base64로 PoC를 한 번 만들어봤다.
결과는 단순했다 — PoC 환경(브라우저 + 인터넷 RTT + 서버 인코딩 포함)에서 약 10fps 수준에서 처리량이 막혔다. 목표였던 실시간 영상 체감(최소 24~30fps)의 3분의 1 수준이었다. (참고로 §10의 로컬 마이크로벤치에서는 같은 직렬화 방식이 VGA 기준 약 22fps를 보였다 — 실제 운영 환경의 네트워크·인코딩 오버헤드가 이만큼 더해진다는 점이 PoC 수치와 마이크로벤치 수치의 차이를 설명한다.) 더 본질적인 건, 그 한계가 우연한 병목 때문이 아니라 프로토콜 선택 자체에서 비롯됐다는 점이었다. 돌려보면서 세 가지 원인이 잡혔다.
첫째, base64 오버헤드. JSON 메시지에 영상 프레임을 실으려면 base64로 인코딩해야 하고, 이는 원본 바이트 대비 약 33%의 페이로드를 더한다. 초당 30프레임, 프레임당 50KB 기준으로 사용자 1인당 추가 트래픽이 수십 Mbps 단위로 불어난다. 동시 접속자가 늘면 이 비용은 선형으로 누적된다.
둘째, TCP의 헤드오브라인 블로킹. TCP는 순서 보장을 제공한다. 좋은 보장처럼 들리지만, 영상 도메인에서는 정반대로 작동한다. 패킷 하나가 늦게 오거나 손실되면 그 뒤에 이미 도착해 있는 모든 프레임 데이터가 함께 멈춰서 기다린다. 영상은 과거 한 프레임의 손실이 전체 스트림의 일시 정지보다 훨씬 나은 도메인인데, TCP는 정확히 반대의 트레이드오프를 강제한다.
셋째, 재전송의 무의미함. 놓친 프레임을 TCP가 다시 보내줘도, 그때는 이미 다음 프레임이 도착해 있다. 사용자에게는 3프레임 전의 얼굴이 화면에 떠 있는 게 아무런 가치도 없는데, 우리는 그 재전송의 비용을 그대로 치르고 있었다.
세 가지가 모두 TCP 위의 WebSocket이 제공하는 보장이 우리 도메인에서는 오히려 부담이라는 한 방향을 가리켰다. WebRTC의 UDP/SRTP는 정확히 반대 설계 철학을 가진다 — 손실을 허용하되, 지연을 최소화한다. 우리가 필요로 한 건 정확히 이 철학이었다.
추가로 따라온 장점도 분명했다. WebRTC는 브라우저 네이티브 API(getUserMedia, RTCPeerConnection)라 별도 클라이언트 SDK가 필요 없고, STUN/TURN을 통한 NAT Traversal이 표준에 포함되어 있어 가정용 라우터 뒤의 사용자에게도 연결이 닿는다. 우리의 도메인 요구사항을 정확히 만족시키는 한편, *"브라우저만 있으면 쓴다"*는 프로젝트 출발점과도 맞아떨어졌다.
솔직히 말하면, WebSocket이 잘못된 선택이라는 뜻은 아니다. 채팅이나 시그널링처럼 모든 메시지가 도착해야 의미가 있는 도메인에서는 여전히 WebSocket이 더 나은 선택이다. WebRTC는 손실 허용 + 저지연이 가치를 갖는 좁은 도메인에서 빛난다. 우리 시스템에서도 WebRTC는 미디어 채널에만 쓰이고, 시그널링 자체(SDP Offer/Answer)는 일반 HTTP API로 처리한다.
6. Why ZeroMQ — 과거를 빨리 잊는 메시징이 필요했다
MQ 선택을 앞두고, 세 가지 후보를 동일 기준으로 비교했다.
| Kafka | RabbitMQ | Redis Streams | ZeroMQ | |
|---|---|---|---|---|
| 메시지 영속 | 필수 기본값 | 옵션 | 옵션 | 없음 |
| 운영 레이어 | 브로커 + ZK/KRaft | 브로커 | Redis 서버 | 브로커리스 |
| p99 지연 | 수십 ms | 수 ms | 수 ms | 1–5 ms |
| 영상 프레임 적합도 | 과보호 | 과보호 | 애매 | 적합 |
📎 p99 지연 수치는 우리가 직접 측정한 값이 아니라 일반적으로 공유되는 범위다 — Kafka/RabbitMQ는 공식 문서와 운영 사례 보고에 자주 인용되는 값이고, ZeroMQ는 zguide.zeromq.org의 가이드와 일반 벤치마크에서 한 자릿수 ms로 보고되는 범위다. 정확한 값은 페이로드 크기·네트워크 환경·하드웨어에 크게 의존하며, 이 표의 의도는 절대 수치 비교가 아니라 자릿수의 차이를 드러내는 데 있다.
비교를 한 줄로 요약하면, 우리 도메인의 메시지는 과거가 빨리 잊혀야 하는 영상 프레임이었다. Kafka의 강력한 영속성과 재처리 가능성은 결제 이벤트나 로그 수집에는 핵심 가치지만, 실시간 FaceSwap 도메인에서는 정반대로 작동한다. 3초 전에 던졌어야 할 프레임이 디스크에 남아 있다가 재처리되는 상황은 사용자 경험을 망치는 시나리오다. 빠르게 잃어버리는 것이 미덕인 메시지였다.
RabbitMQ도 비슷한 이유로 빠졌다. AMQP의 queue/exchange/binding 추상화는 강력하지만 — 그리고 그 강력함을 위해 메시지마다 ack/durable/routing 비용을 치른다 — 우리가 보내는 건 초당 수십 개의 짧은 프레임이었다. 보장 없이 빨리 흘려보내는 쪽이 도메인 요구사항이었다.
운영 측면에서도 결정 요인이 있었다. Kafka도 RabbitMQ도 별도의 브로커 프로세스를 띄워야 한다. Zookeeper(또는 KRaft) 구성, 백압 정책, 디스크 영속 설정, 이벤트 보존 기간 — 1인 개발과 스타트업 초기 운영에서는 이 운영 오버헤드 자체가 메시징 본체보다 큰 비용이 된다. 브로커 한 프로세스를 잘 운영하는 능력과 메시지를 잘 흘려보내는 능력은 다른 종류의 노력이다.
ZeroMQ를 고른 이유는, 별도 브로커 프로세스를 띄울 필요 없이 소켓 위에 얹는 이름 있는 메시징 패턴이기 때문이다. DEALER/ROUTER 패턴은 그 자체가 "비동기 양방향 작업 분배기"라서, 우리의 토폴로지 — Signaling이 다수의 Worker에게 작업을 흘리고, 결과를 다시 비순서적으로 회수해야 하는 — 와 정확히 맞아떨어졌다. p99 지연이 한 자릿수 밀리초 단위로 머무른다는 점도, 초당 수십 프레임을 흘려야 하는 시스템에서 결정적인 보너스였다.
솔직히 말하면, ZeroMQ가 모든 경우에 더 나은 선택이라는 뜻은 아니다. 메시지를 절대 잃으면 안 되는 도메인이라면 우리는 첫 줄에서 Kafka로 갔을 것이다. 우리의 결정은 우리 도메인의 요구사항이 무엇이 아닌지를 명확히 한 뒤의 결과였다.
7. Why msgpack — 바이너리를 그대로 패킹하는 직렬화
페이로드 직렬화에는 msgpack을 썼다. 결정의 이유는 단순했다 — 우리가 보내는 메시지의 본체는 영상 프레임의 원시 바이트였다.
JSON으로 영상 프레임을 보내려면 base64 인코딩이 필요하고, 이는 원본 대비 약 33%의 페이로드 증가를 의미한다. §5에서 이미 이 비용이 우리 도메인에서 얼마나 가파르게 누적되는지 봤다. msgpack은 바이너리를 그대로 패킹한다. tuple과 dict를 그대로 직렬화할 수 있어, 메타데이터(타임스탬프, frame_id, shape, dtype, event_type)와 raw bytes를 하나의 메시지로 묶기에도 자연스럽다.
실제 페이로드 구조는 다음과 같다:
payload = (
    time.time(),       # timestamp
    frame_id,          # frame UUID (correlation)
    frame.shape[0],    # height
    frame.shape[1],    # width
    frame_bytes,       # raw bytes
    frame.shape,
    str(frame.dtype),
    EVENT_PRE_FRAME
)
serialized = msgpack.packb(payload, use_bin_type=True)
이 페이로드의 두 번째 필드 frame_id는 — §11에서 다룰 프레임 꼬임 사건의 흔적이다.
8. Why 3-Tier — 책임 경계의 설계
3-Tier로 책임을 나눈 가장 강한 동기는 GPU VRAM 격리였다.
GPU 메모리는 CPU 메모리보다 한 자릿수 더 비싸고, 한 번 점유한 VRAM은 프로세스를 종료할 때까지 좀처럼 깨끗하게 회수되지 않는다. 더 까다로운 점은 CUDA 컨텍스트다. ONNX Runtime이 CUDA 위에서 도중에 어떤 이유로든 꼬이면 — OOM, 드라이버 일시 오류, 모델 로드 실패 — 회복하는 가장 안전한 방법은 프로세스 전체를 재시작하는 것이다.
문제는, Signaling 서버가 같은 프로세스 안에 있으면 사용자와의 WebRTC 연결도 같이 죽는다는 점이다. WebRTC는 PeerConnection을 다시 맺으려면 SDP Offer/Answer 교환부터 ICE 후보 수집, NAT Traversal까지 적지 않은 라운드트립을 다시 거쳐야 한다. 추론 한 번 꼬였다고 모든 사용자의 연결이 끊기게 둘 수는 없었다.
그래서 GPU를 만지는 영역은 Worker라는 별도 컨테이너에 두기로 했다. CUDA 컨텍스트가 문제를 일으키면 해당 Worker만 재시작하면 된다. Signaling은 CPU 영역에 머물며 사용자와의 연결을 그대로 유지한다.
여기에 MQ를 사이에 끼운 이유는, Signaling이 특정 Worker를 직접 알면 안 됐기 때문이다. 사용자 수가 늘면 Worker를 docker compose scale worker=N으로 늘려야 하는데, Signaling이 Worker의 주소·생명주기를 알고 있으면 Worker 한 대를 추가/제거할 때마다 Signaling 코드를 바꿔야 하는 구조가 된다. ZMQ ROUTER 패턴을 사이에 두면 Worker는 **동적으로 늘었다 줄었다 하는 풀(pool)**이 된다. Signaling은 단지 MQ에 프레임을 던지고 결과를 받을 뿐, Worker가 몇 대인지·어떤 Worker가 자기 프레임을 처리했는지 알 필요가 없다.
정리하면 — GPU 자원의 비싼 격리 비용이 Worker를 떼어내는 1차 동기였고, Worker 수의 동적 변동에 Signaling이 결합되지 않도록 MQ를 사이에 끼웠다. 결과적으로 세 계층 모두 자기 책임의 변경 사유가 서로 다른 구조가 되었다.
9. 구현 — 핵심 흐름
다음에 소개하는 흐름은 3-Tier 분산 구조에서의 핵심 코드 경로다.
핵심 구현 흐름을 코드 단위로 짧게 살펴본다.
WebRTC offer 처리 (src/signal/main.py:96-128)
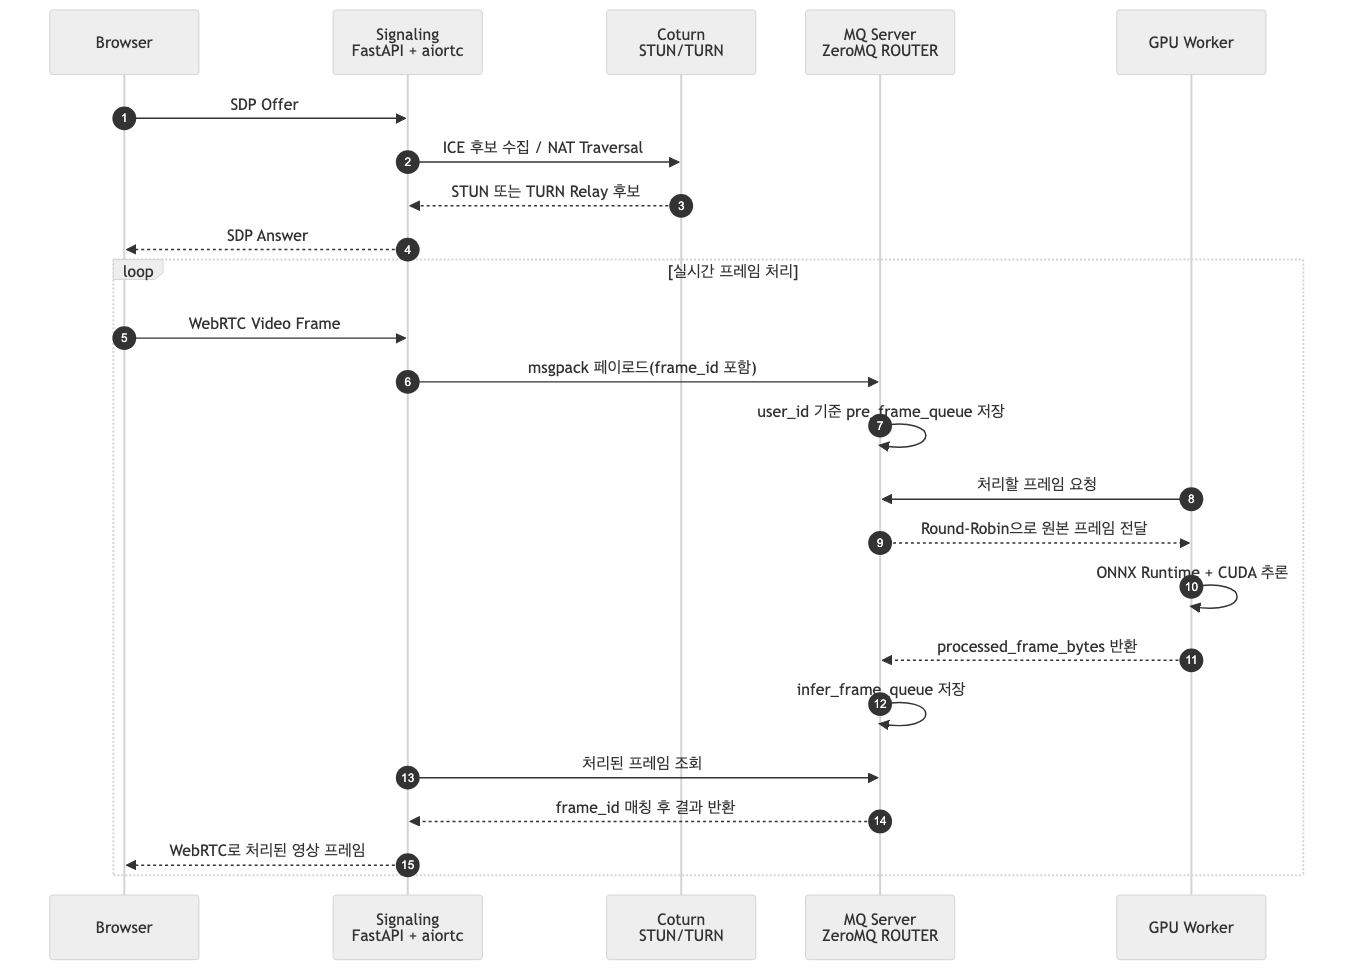
브라우저가 보낸 SDP offer를 받아 RTCPeerConnection을 만들고, ICE 후보 수집 후 SDP answer를 반환한다. 표준 WebRTC 시그널링 흐름이다.
VideoTransformTrack의 프레임 루프 (webrtc_handler.py:33-189)
WebRTC가 보낸 원본 프레임을 recv()로 받고, 처리된 프레임을 다시 send로 내보낸다. 그 사이에서 ZMQ DEALER로 MQ에 프레임을 던지고, 응답을 받아 frame_id로 매칭한 뒤 화면에 뿌린다.
ZMQ DEALER 페이로드 전송 (queue_manager.py:99-109)
§7에서 본 msgpack 페이로드를 DEALER 소켓으로 MQ Main Router(:6000)에 전송한다. 응답은 별도 DEALER 소켓을 통해 Send Router(:7070)에서 회수된다.
asyncio 루프 보호 (webrtc_handler.py:68)
processed_frame = await self._loop.run_in_executor(
    None, self._process_frame, frame
)
블로킹 작업은 ThreadPoolExecutor에 오프로드한다. §11에서 다룰 이벤트 루프 얼음 사건의 해결책이다.
10. 결과 — 정량 측정
본 결과는 로컬 loopback 환경에서의 마이크로벤치다. 실제 분산 시스템의 네트워크 RTT, GPU 추론 시간, 동시 사용자 부하는 포함되지 않는다. 측정의 목적은 §5와 §6에서 다룬 트레이드오프가 실제로 측정 가능한 차이로 나타나는지를 확인하는 데 있다.
페이로드 크기 — 직렬화 방식별 비교
동일 해상도의 영상 프레임을 두 방식으로 직렬화한 후 페이로드 크기를 비교했다.
| Resolution | Raw bytes | JSON+base64 | msgpack | base64 overhead |
|---|---|---|---|---|
| QVGA 320×240 | 230,400 | 307,401 | 230,481 | +33.42% |
| VGA 640×480 | 921,600 | 1,229,002 | 921,683 | +33.36% |
| HD 1280×720 | 2,764,800 | 3,686,603 | 2,764,883 | +33.34% |
| FHD 1920×1080 | 6,220,800 | 8,294,604 | 6,220,883 | +33.34% |
JSON+base64는 모든 해상도에서 약 +33.3%의 오버헤드가 일관되게 나타났다. 이는 base64 인코딩의 이론적 오버헤드(3바이트 → 4문자)와 정확히 일치한다. 반면 msgpack은 메타데이터 수십 바이트를 제외하면 **사실상 오버헤드 0%**다. FHD 30fps 기준으로 환산하면, JSON+base64 방식은 사용자 한 명당 약 62 MB/s (≈ 498 Mbps)의 추가 대역폭을 소모한다 — 동시 사용자가 늘면 이 비용은 선형으로 누적된다.
직렬화·송수신 처리량 — 프로토콜별 비교
같은 페이로드를 echo 패턴으로 300프레임 round-trip 송수신했을 때의 처리량은 다음과 같다.
| Resolution | Protocol | Throughput (fps) |
|---|---|---|
| VGA 640×480 | WebSocket + JSON + base64 | 22.2 |
| VGA 640×480 | ZMQ + msgpack | 2,448.8 |
| HD 1280×720 | WebSocket + JSON + base64 | 7.4 |
| HD 1280×720 | ZMQ + msgpack | 979.1 |
로컬 환경에서도 WebSocket+JSON+base64는 VGA 22fps, HD 7.4fps 수준에서 처리량이 막혔다. 실제 분산 환경에서는 여기에 인터넷 RTT, WebRTC 시그널링 오버헤드, 브라우저 측 인코딩 비용이 더해진다는 점을 감안하면 — §5에서 언급한 "PoC에서 약 10fps 한계" 관찰이 이 측정과 같은 패턴 위에 있음을 알 수 있다. ZMQ+msgpack은 같은 조건에서 두 자릿수 배수 더 높은 처리량을 보였다.
측정 중 발견 — WebSocket의 기본 페이로드 제한
측정 스크립트를 처음 실행했을 때, websockets 라이브러리가 기본값으로 1MB 초과 메시지를 차단했다. 이를 해제하려면 서버와 클라이언트 양쪽에 max_size=None을 명시해야 한다. 영상 프레임이 WebSocket의 표준 사용 범위를 벗어나는 메시지 크기라는 점은, §5에서 WebSocket을 선택지에서 제외한 결정의 환경적 증거가 된다 — 라이브러리 제작자들조차 이 정도 크기의 메시지를 일반적인 사용 패턴으로 가정하지 않는다.
한계와 다음 측정
본 측정은 직렬화와 동일 머신 IPC 비용까지를 다루며, 다음 항목은 측정 범위에 포함되지 않는다:
- 실제 네트워크 RTT — 인터넷 환경의 추가 지연 (수십~수백 ms)
- GPU 추론 시간 — 모델별 수십~수백 ms 변동
- 동시 사용자 부하 — N명 동시 접속 시 Worker 풀 동작 (§11의 frame 꼬임 사건이 일어났던 구간)
- End-to-End 지연 — 브라우저 캡처 → 화면 표시 전체 경로
절대값보다 중요한 것은 — §5와 §6에서 분석한 트레이드오프가 실측 패턴과 일치한다는 점이다. base64 오버헤드는 이론치와 정확히 일치했고, 직렬화 방식의 차이가 처리량에 두 자릿수 배수의 영향을 미쳤다. 글의 모든 설계 결정은 이 측정 위에 다시 한 번 놓였을 때도 같은 방향을 가리킨다.
11. 운영하며 배운 것
분산 구조를 처음 띄웠을 때는, *"Worker가 N개니까 처리량이 N배"*라는 단순한 모델로 생각했다. 운영하면서 이 모델이 깨지는 두 순간이 있었다.
첫 번째 — frame이 꼬였다
Worker가 2대 이상일 때, 종종 화면이 한 프레임 뒤로 깜빡이는 현상이 나타났다. 처음에는 네트워크 지터 문제로 보였지만, 들여다보니 더 단순한 원인이었다 — Signaling이 받은 응답을 어떤 요청에 대한 것인지 식별할 수 없었다. Worker A에 보낸 frame_t와 Worker B에 보낸 frame_t+1이 동시에 처리되는데, 두 Worker의 처리 시간이 다르면 응답이 거꾸로 도착한다. Signaling은 그저 "도착한 순서대로" 화면에 뿌리고 있었기에, 옛 프레임이 새 프레임을 덮어쓰는 일이 벌어진 것이다.
해결은 단순했다. 요청 페이로드에 frame_id(UUID)를 박고, 응답이 도착하면 frame_id로 매칭한 뒤 더 최신 프레임이 이미 도착했다면 옛 응답은 버리는 로직을 추가했다. 분산 시스템에서 *"응답이 요청을 식별할 수 있어야 한다"*는 평범한 진리가, 영상처럼 순서가 흐트러지면 사용자가 즉시 알아채는 도메인에서는 더더욱 단단하게 잡혀 있어야 한다는 걸 배웠다. 지금 코드에 박혀 있는 frame_id 필드는 그 사건의 흔적이다.
두 번째 — asyncio 이벤트 루프가 얼었다
WebRTC 미디어 채널은 asyncio 위에서 돈다. ZMQ 호출이나 추론 결과 후처리 같은 짧지만 블로킹인 작업이 같은 루프에서 실행되면, 그 사이에 들어오는 다음 프레임의 송수신이 지연된다. 사용자 입장에서는 "1초마다 한 번씩 영상이 살짝 멈추는" 식의 미세한 끊김으로 나타났다.
해결 자체는 표준 패턴이었다. asyncio.run_in_executor로 블로킹 작업을 ThreadPoolExecutor에 오프로드해, 메인 이벤트 루프는 미디어 채널의 송수신만 담당하도록 분리했다. 코드 변경 자체는 몇 줄이었지만 — 비동기 시스템에서 "절대 막히면 안 되는 루프"를 식별하는 사고는 분산이라는 큰 경계뿐 아니라 단일 프로세스 안의 작은 경계에서도 똑같이 필요하다는 점을 명확히 했다.
마지막으로 — 원인은 계층을 분리해서 봐야 한다
추론 결과 품질 이슈가 생겼을 때, 처음엔 분산 구조 자체를 의심했다. 하지만 계층을 하나씩 분리해 들여다보니 원인은 분산 구조가 아니라 추론 모델 자체에 있었다. 여러 계층이 얽힌 시스템에서는 증상이 나타난 곳과 원인이 있는 곳이 다른 경우가 많다. 장애를 만나면 계층 경계를 따라 원인을 좁혀가야 한다는 걸, 한 번 헤매고 나서야 익혔다.
세 사건의 공통점
세 사건을 돌이켜보면, 공통점이 하나 있다. 코드를 돌려보지 않으면 보이지 않는 경계가 있다는 점이다. 처음부터 frame_id를 박지 않은 것도, ThreadPoolExecutor 없이 짠 것도, 원인을 엉뚱한 계층에서 찾은 것도 — 경계의 본질을 충분히 이해하기 전에 코드를 먼저 짠 결과였다. 분산이든 비동기든, 단일 머신의 함수 호출에서는 보이지 않던 보장의 틈이 그 경계에 늘 있다.
12. 마무리
Veilio Cloud의 3-Tier 분산 설계에서 가장 자주 떠올렸던 질문은 *"이 책임은 어느 계층에 있어야 하는가"*였다. 답은 단순했지만 — 사용자 경험은 Signaling이, 메시지 라우팅은 MQ가, 무거운 연산은 Worker가 — 그 단순함을 유지하는 일이 가장 어려운 일이기도 했다.
다시 같은 시스템을 만든다면, 지금의 ZMQ ROUTER를 한 번 더 비교해보고 싶은 후보가 있다. NATS JetStream은 ZMQ의 가벼움을 유지하면서도 단순한 영속 옵션과 운영 도구를 함께 제공한다. gRPC bidirectional streaming은 ZMQ DEALER/ROUTER와 비슷한 양방향 패턴을 HTTP/2 위에서 제공하고, 관찰성 도구가 더 풍부하다. 두 후보 모두 우리의 핵심 트레이드오프(과거를 빨리 잊는 메시지 + 브로커리스 또는 경량 운영) 위에서 다시 한번 비교해볼 가치가 있다.
그러나 이 모든 결정의 핵심은 도구 선택 자체가 아니다. 각 계층의 책임이 무엇이고, 어떤 보장이 그 경계에서 흐트러질 수 있는지를 미리 이해하는 것 — 그것이 분산 시스템 설계의 본질이고, Veilio Cloud를 만들며 가장 많이 배운 것이다.
댓글 0
아직 댓글이 없습니다. 첫 번째 댓글을 작성해보세요!